

27 de novembro de 2025
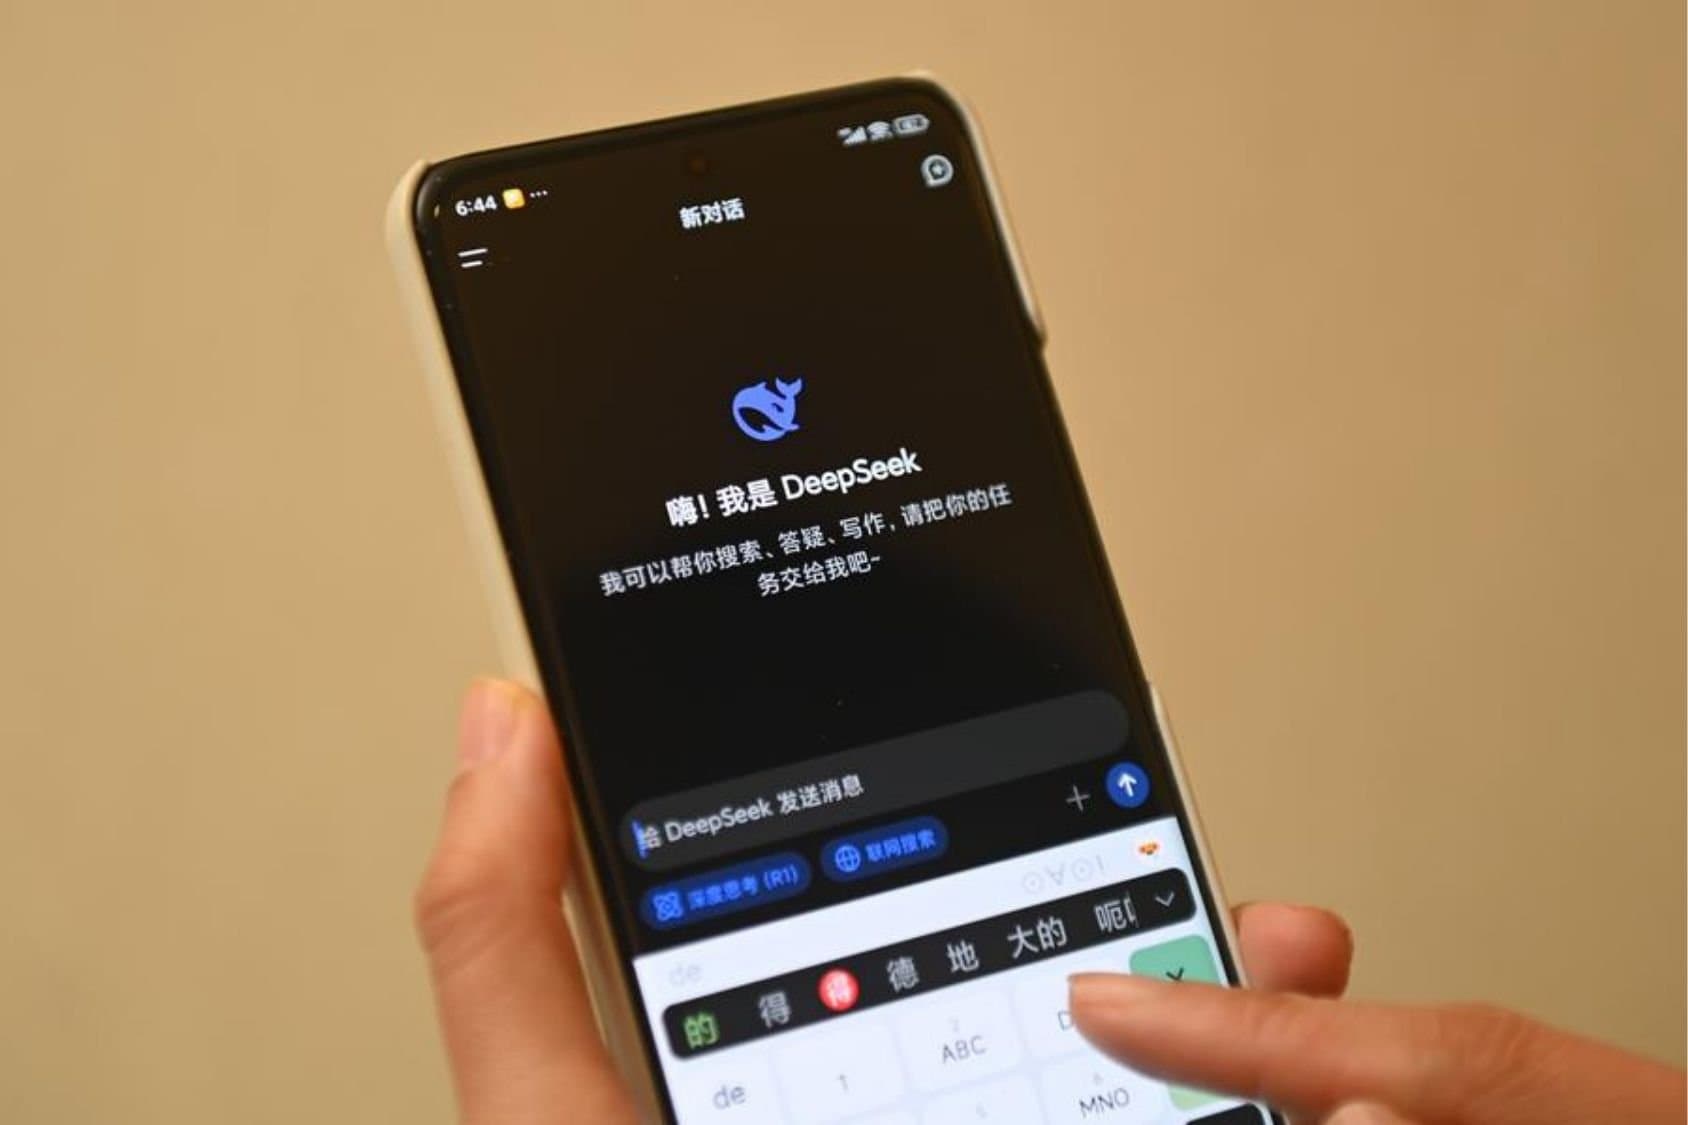
A DeepSeek apresentou nesta semana o DeepSeekMath-V2, uma estrutura de treinamento capaz de verificar automaticamente o próprio raciocínio matemático. A ferramenta busca superar limitações de modelos que avaliam apenas a resposta final, especialmente em tarefas que exigem derivação passo a passo, como demonstrações de teoremas. O sistema constrói um validador baseado em LLM (grande modelo de linguagem) que revisa automaticamente as demonstrações geradas. Além disso, gera continuamente amostras de treinamento desafiadoras, aplicando cálculos de validação estendidos para aprimorar suas capacidades de verificação. De acordo com o IT Home, o DeepSeekMath-V2, baseado no DeepSeek-V3.2 -Exp-Base, conquistou medalha de ouro na Olimpíada Internacional de Matemática (IMO) de 2025 e na Olimpíada Chinesa de Matemática (CMO) de 2024. O modelo também obteve a pontuação de 118 em 120 na Competição Putnam de Matemática de 2024. Em nota oficial, a DeepSeek afirmou que, embora ainda haja desafios a serem superados, os resultados indicam que o raciocínio matemático autoverificável representa um caminho viável para desenvolver sistemas de inteligência matemática mais confiáveis e avançados. Fonte: ithome

16 de outubro de 2025
Pesquisadores da Universidade Politécnica de Hong Kong e do Tencent ARC Lab desenvolveram o UniPixel, o primeiro grande modelo multimodal capaz de identificar alvos, segmentar imagens e raciocinar sobre regiões ao mesmo tempo. O artigo foi aceito pelo NeurIPS 2025, e código, dados e demonstração são abertos ao público. Modelos tradicionais, como o GPT-5 e o Gemini 2.5 Pro, conseguem “entender” imagens de forma geral, mas têm dificuldade em identificar detalhes precisos e raciocinar sobre áreas específicas. Isso limita aplicações em diagnóstico médico, direção autônoma e interação com humanos, além de reduzir a precisão em tarefas que exigem controle e explicações detalhadas. O UniPixel supera essas limitações usando um fluxo de “percepção-memória-raciocínio”. Ele combina um Banco de Memória de Objetos e um codificador visual capaz de processar três tipos de prompts visuais: pontos, caixas e máscaras. Com isso, o modelo identifica o alvo indicado pelo usuário e usa essas informações em respostas subsequentes, gerando descrições, segmentações e respostas em linguagem natural. Sua arquitetura se baseia no Qwen2.5-VL, suporta imagens e vídeos e processa múltiplos tipos de prompts ao mesmo tempo. O usuário fornece imagem ou vídeo, texto e prompts visuais opcionais, e o modelo produz respostas em texto e máscaras espaço-temporais, permitindo análises detalhadas. O UniPixel possui três módulos principais: Codificador de prompts: transforma pontos, caixas e máscaras em vetores de alta dimensão, incluindo posição e tipo do prompt; Banco de Memória de Objetos: armazena áreas-alvo indicadas pelo usuário, permitindo múltiplas rodadas de referência e raciocínio contextual; Decodificador de máscara: gera máscaras precisas e integra segmentação e compreensão do objeto. O modelo também adiciona tokens especiais ao LLM, como <REF>, <MEM> e <SEG>, conectando a linguagem à percepção visual. Isso permite consultas complexas, como comparar comportamentos de dois objetos em diferentes momentos de um vídeo e gerar respostas precisas indicando cada área. O treinamento é feito em fases: primeiro, pré-treina o codificador visual e o LLM; depois, integra os módulos de prompts, memória e máscara em treinamento conjunto. Foram usadas cerca de 1 milhão de amostras de texto, imagens e vídeos, cobrindo diferentes tipos de prompts, garantindo que o modelo funcione em variadas tarefas. Fonte: 36kr
28 de maio de 2024
A China Telecom , uma das maiores operadoras de telefonia sem fio do país, revelou o primeiro modelo de linguagem grande da China que pode entender simultaneamente mais de 30 dialetos locais, como o de Cantão, Xangai e Wenzhou. A inovação visa tornar o atendimento ao cliente mais eficiente. O modelo de reconhecimento de fala, lançado no último fim de semana, foi testado no atendimento ao cliente nas províncias de Fujian, Jiangxi e Guangxi. De acordo com um comunicado de imprensa de um laboratório de inteligência artificial da empresa com sede em Pequim , o modelo pode entender 30 dialetos em questão de segundos e lidar com cerca de dois milhões de chamadas por dia. Além disso, alguns governos locais têm utilizado o modelo em serviços públicos para melhorar o atendimento ao cliente. O LLM é de código aberto, pois o objetivo é proteger os dialetos locais com parceiros e desenvolvedores individuais, informou a China Telecom. A empresa continuará a melhorar o número e a precisão dos dialetos suportados. O plano é construir o primeiro LLM de reconhecimento de fala que suporte dialetos de 333 regiões em nível de prefeitura, bem como as principais línguas minoritárias em toda a China. "O modelo é de grande significado social porque é extremamente urgente proteger os dialetos para transmitir a língua e a cultura", destacou a empresa. A China possui cinco principais famílias linguísticas e mais de 130 idiomas. Cerca de um quinto da população não entende mandarim, um grupo de residentes que muitas vezes vive em áreas rurais e está isolado dos computadores. Além disso, muitos dialetos estão desaparecendo devido ao rápido desenvolvimento socioeconômico da China, acrescentou a empresa. Tradução: Mei Zhen Li Fonte: ScienceNet.cn Imagem principal: OleCNX/ Adobe Stock